首页 / 数据挖掘项目 / 电商客户分群
基于 RFM 模型的电商客户分群 项目 1 · 聚类任务 · 课程设计 B
面对 28,834 条电商订单,运营仍靠「一刀切」投放。本案先按业务口径清洗订单、构建 R / F / M 三维客户价值特征,再用 K-Means、层次聚类、DBSCAN 三种算法交叉验证分群:以肘部法 + 轮廓系数 + CH 指数共同确定 k=3,最终输出三类客群画像与差异化营销策略。
① 背景与业务目标
- 电商订单量大,客户价值差异悬殊,运营资源却平均分配
- 业务目标:识别高价值客户、预警流失风险客户,把预算投到对的人身上
- 核心问题:客户价值能分成几层?各层的消费行为与流失风险差多少?
② 数据集介绍
- 电商平台订单明细:28,834 条记录 × 9 个字段
- 字段:订单状态 / 品牌 / 省份 / 城市 / 实付金额 / 邮费 / 购买数量 / 付款日期
- 清洗后:27,790 条「交易成功」有效订单,聚合出 24,133 位客户进入分群
③ 技术栈
- Python 3 · Pandas / NumPy 数据处理
- Scikit-learn:StandardScaler、KMeans、AgglomerativeClustering、DBSCAN、轮廓系数、CH 指数
- SciPy:linkage / dendrogram 树状图;Matplotlib 可视化;Excel 结果落地
④ 数据处理与特征工程
- 缺失值:分类字段(订单状态 / 省份 / 城市)用众数填充,数值字段(金额 / 邮费 / 数量)用中位数填充
- 重复值:duplicated() 逐条排查完全重复记录,保留首条保证唯一性
- 业务过滤:只保留「交易成功」订单,剔除 1,040 条退款订单,避免退款污染消费金额
- 异常值:自写 3σ 法则函数,对实付金额 / 邮费 / 购买数量逐个剔除极端值
- 特征工程:按客户聚合出 R(最近消费天数)、F(消费频次)、M(消费金额)三维价值特征
- 标准化:Z-score 消除量纲差异——聚类依赖距离计算,不标准化会被金额维度主导
⑤ 建模方案与对比逻辑
- K-Means:遍历 k=2~9,同时看肘部法 SSE 拐点、轮廓系数、CH 指数,三指标共同定 k=3
- 层次聚类:ward 最小方差法 + 树状图观察自然分层,用同一 k=3 与 K-Means 同口径比较
- DBSCAN:eps∈0.3~1.2、min_samples∈{3,5,8,10} 网格寻优,以轮廓系数为主目标选定 eps=1.0 / min_samples=8
- 对比逻辑:三算法统一用轮廓系数 + CH 指数横向比较,再叠业务可解释性做最终选型——不唯指标论
核心代码(Python · 点击放大看全文)
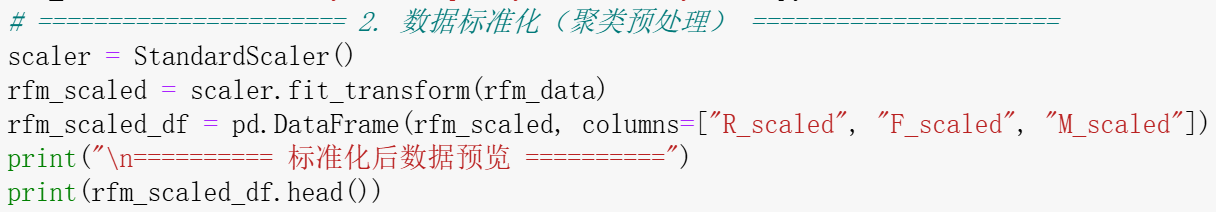
报告图 2-3 · 3σ 异常值剔除 + RFM 三维特征构建(按客户分组聚合 R / F / M)
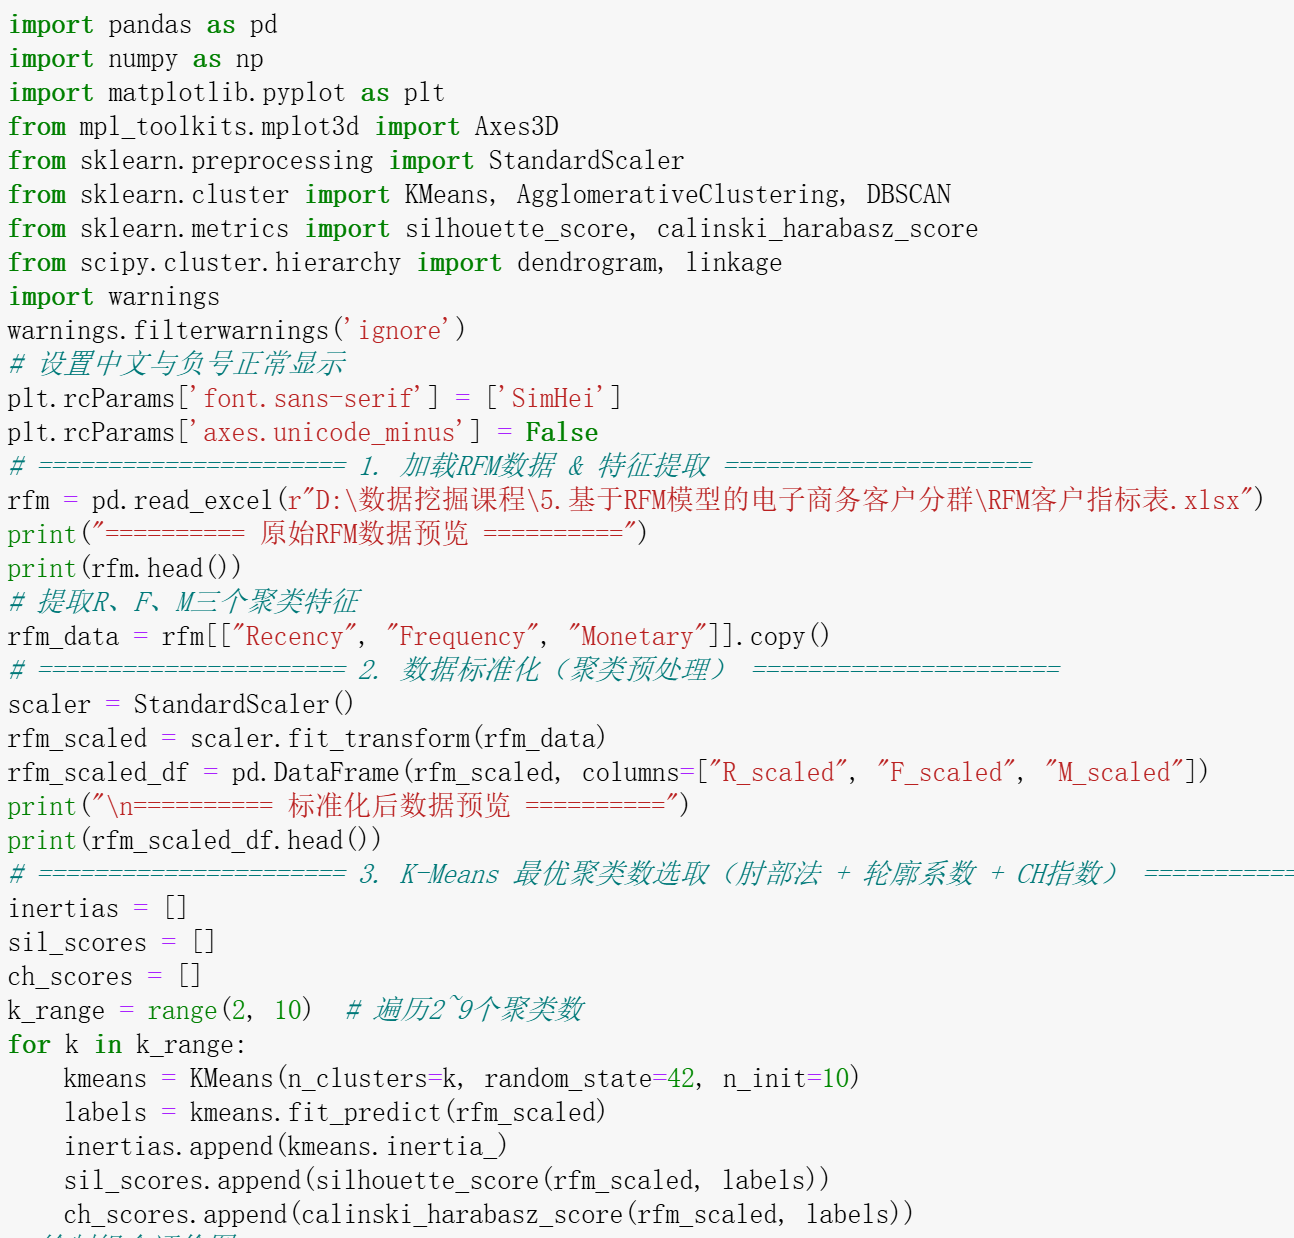
报告图 3-1 · 聚类建模环境加载 + 遍历 k 计算 SSE / 轮廓系数 / CH 指数
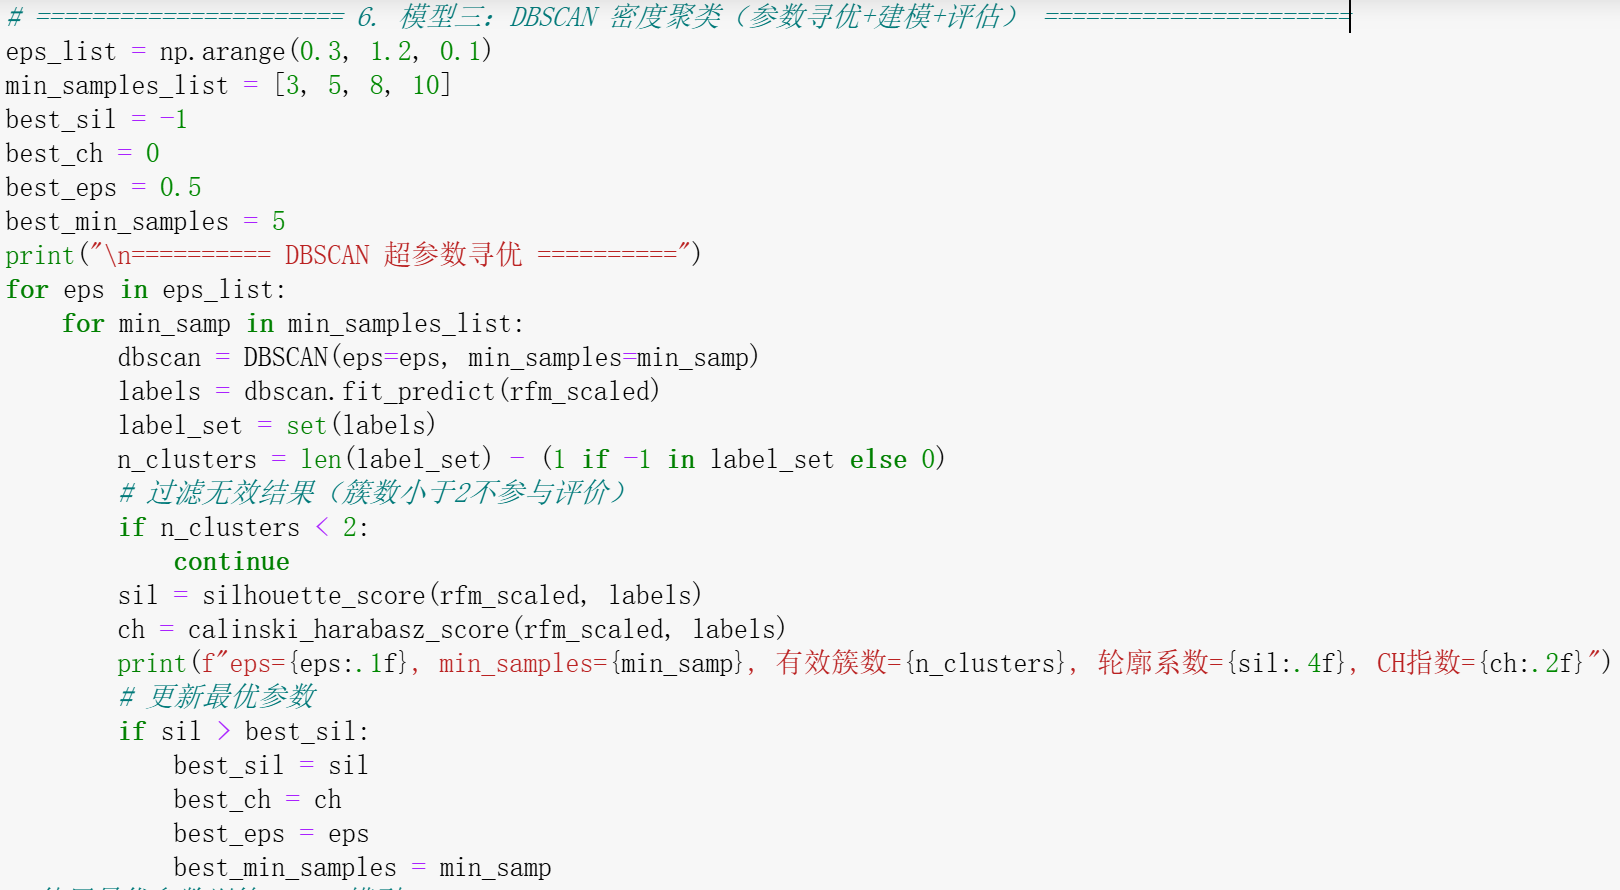
报告图 3-4 · DBSCAN 双层网格参数寻优(以轮廓系数为主目标)
模型评估与可视化(报告原图 · 点击放大)
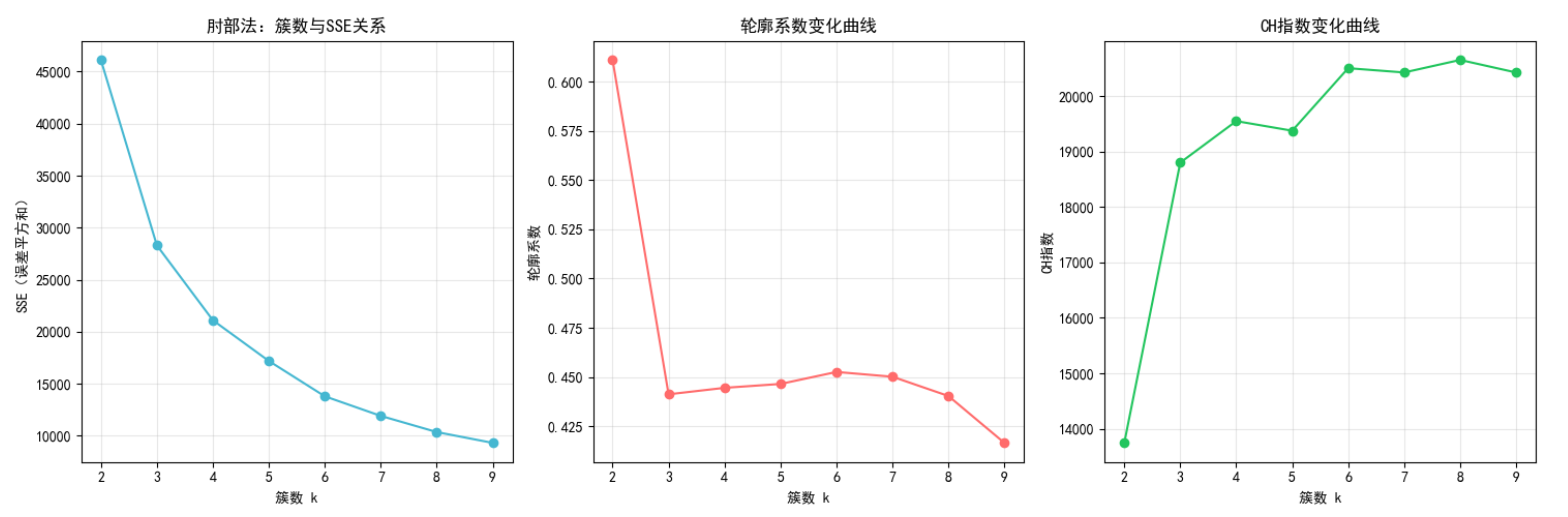
报告图 4-1 · 肘部法 SSE + 轮廓系数 + CH 指数三曲线联手定 k=3
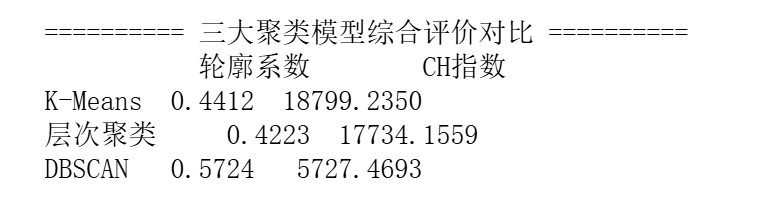
报告图 4-8 · 三种聚类模型综合评价指标对比(选型依据)
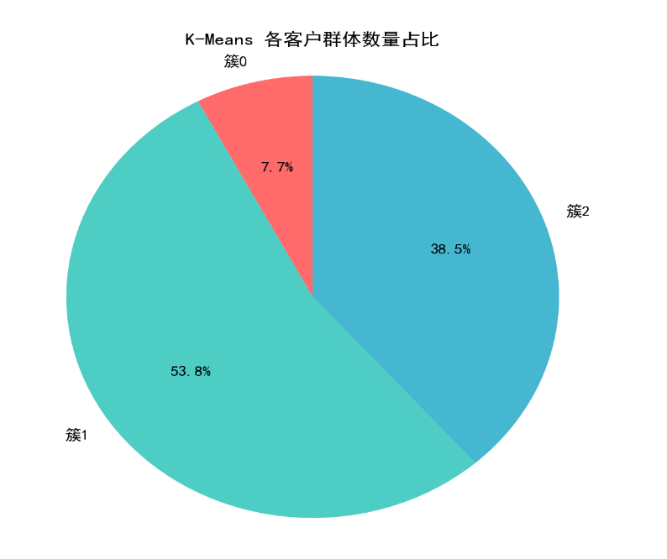
报告图 5-3 · K-Means 三类客群数量占比(53.8% / 38.5% / 7.7%)
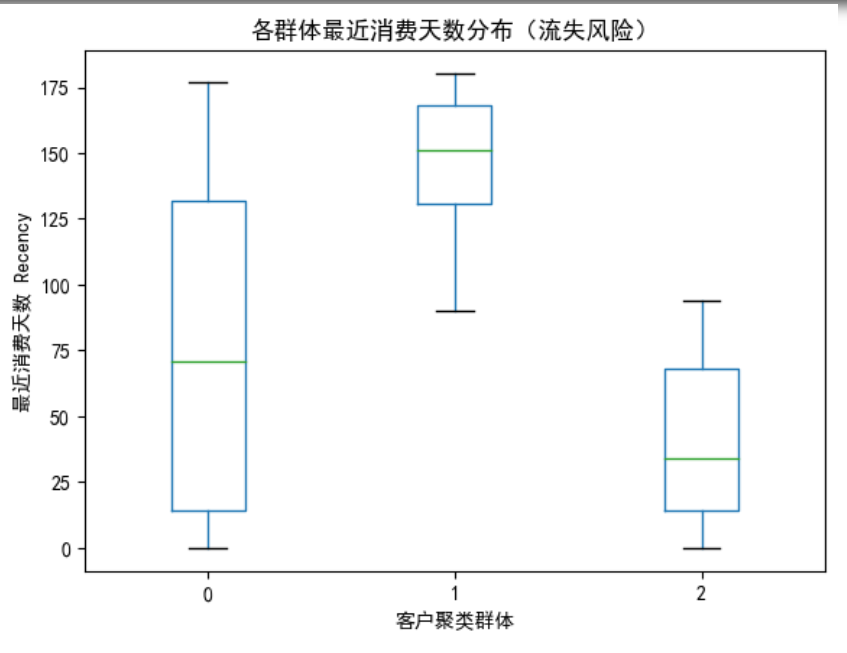
报告图 5-5 · 各客群最近消费天数分布箱线图(流失风险排序)
⑥ 业务结论与落地建议
24,133
客户完成 RFM 分群
3 类
客群结构清晰可命名
3 种
聚类算法交叉验证
4 张
核心评估/业务图表
- 结论:K-Means 综合最优(轮廓系数 0.4412、CH 18799),层次聚类略低(0.4223 / 17734)且结果与 K-Means 高度一致;DBSCAN 轮廓系数虽最高(0.5724)但 CH 仅 5727、噪声与碎片化严重,分群粒度与运营场景不匹配
- 客群画像:核心高价值 1,859 人(R≈74 天 / F=2.14 次 / M≈266 元)、新活跃潜力 9,297 人(R≈39 天 / M≈127 元)、沉睡低价值 12,977 人(R≈144 天 / M≈122 元)
- 落地建议:核心客户给专属权益与优先发货;潜力客户用复购券 + 凑单推荐拉频次;沉睡客户短信 / 优惠券召回;商品侧——单件订单推满减凑单,多件订单推低价组合套装
⑦ 项目难点与反思改进
- 难点 1|时间格式不统一 + 金额缺失:用 to_datetime(errors='coerce') 统一格式;按业务口径分别处理——时间缺失剔除、金额缺失用该用户历史均值填充
- 难点 2|k 值靠主观判断:单一指标会偏差(k=2 轮廓系数最高 0.61 但分群过粗、CH 偏低),最终以三指标 + 业务可解释性共同锁定 k=3
- 难点 3|簇标签只是一个数字:用 RFM 均值表 + 箱线图刻画每簇特征,把 0 / 1 / 2 映射成「核心价值 / 沉睡流失 / 新活跃潜力」业务命名
- 改进方向:引入 RFM 打分分层(1~5 标度)做交叉验证;补充 CLV / 复购预测;对类别特征改用 K-Prototypes 处理
🎯 个人贡献
- 独立设计分析方案:从 RFM 特征口径、三算法对比路径到业务命名映射的完整技术路线
- 独立编写全部 Python 代码:数据探索、清洗、特征工程、三种聚类建模、参数寻优与可视化
- 完成课程设计说明书与答辩,将聚类结果翻译为可执行的差异化运营策略