首页 / 数据挖掘项目 / 金联储用户聚类
金联储金融平台用户聚类分析 案例 4 · 聚类任务 · 拓展小案例
互联网金融平台的运营难题是「用户结构高度分化、资源却平均投放」。本案例以金联储 5 项核心资金指标为特征,经标准化后做 K-Means 聚类,用肘部法 + 轮廓系数共同锁定 K=3,输出三类用户的画像分层,并借指标相关性与地区分布补足业务解读——侧重金融行业洞察,不再复述完整建模流程。
① 背景与业务目标
- 平台用户投资规模差异极大:中位数仅 1,000 元,却存在单笔超 500 万的高净值用户
- 业务目标:按资金行为把用户分层,让运营资源投向真正有复投与增投潜力的人群
- 核心问题:用户能分成几层?各层的投资规模、活跃度与收益差多少?
② 数据集与指标
- 金联储平台用户资金数据,选取 5 项核心指标:累计投资、已投标数、代收本金、代收利息、账户可用余额
- 经数据清洗 + Z-score 标准化后进入聚类(各指标量级差几个数量级,不标准化会被「累计投资」主导)
- 分布特征:累计投资呈长尾分布,50% 用户仅投 1 笔;代收本金 / 利息中位数为 0(超半数用户尚未回款)
③ 技术栈与聚类方案
- Python · Pandas 数据处理 · Scikit-learn StandardScaler / KMeans / PCA · Matplotlib 可视化
- 选 K 逻辑:肘部法看簇内平方和(SSE)拐点,轮廓系数看簇内紧凑度与簇间区分度,两法一致指向 K=3
- 结果解读:PCA 降维到 2 维做分布校验,再叠指标均值表与相关性分析完成业务命名
模型评估与可视化(报告原图 · 点击放大)
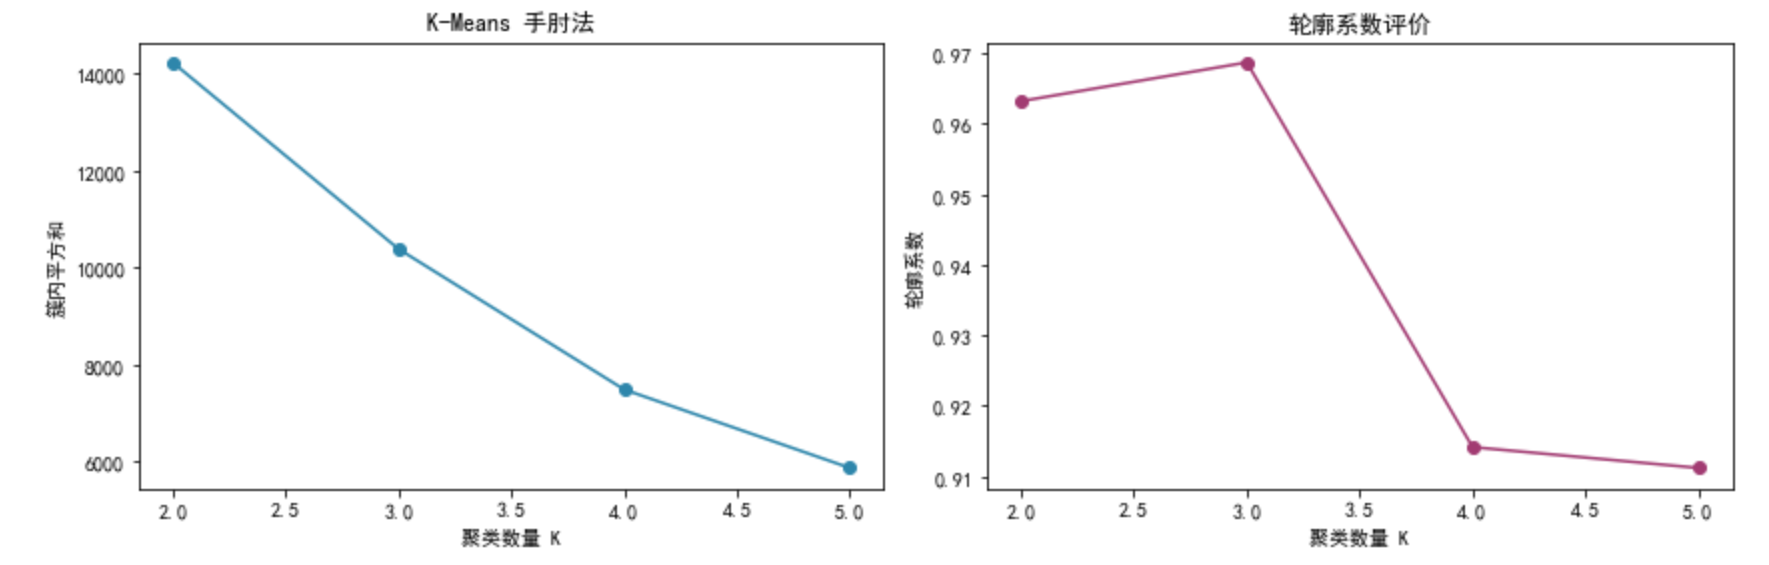
报告图 1 · 手肘法 SSE 拐点 + 轮廓系数峰值(K=3 时 ≈0.97)共同定 k=3
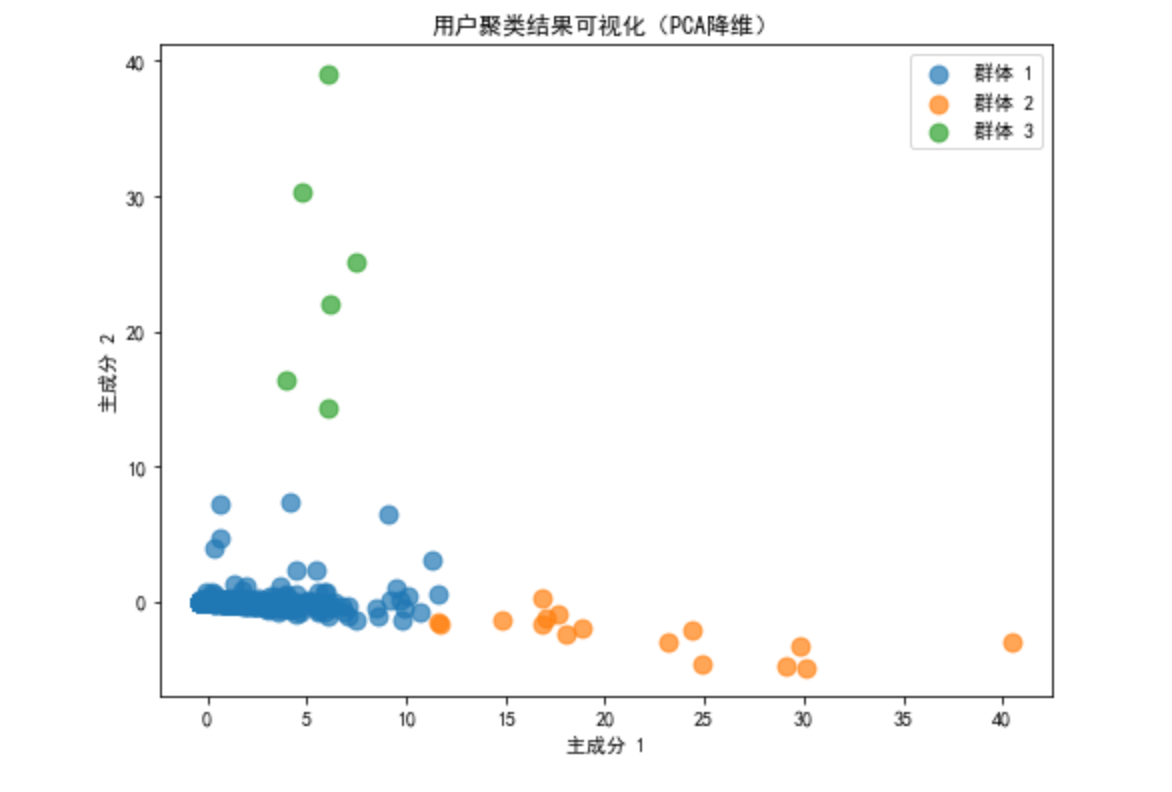
报告图 2 · PCA 降维后三类用户分布(三簇界线清晰、无明显重叠)
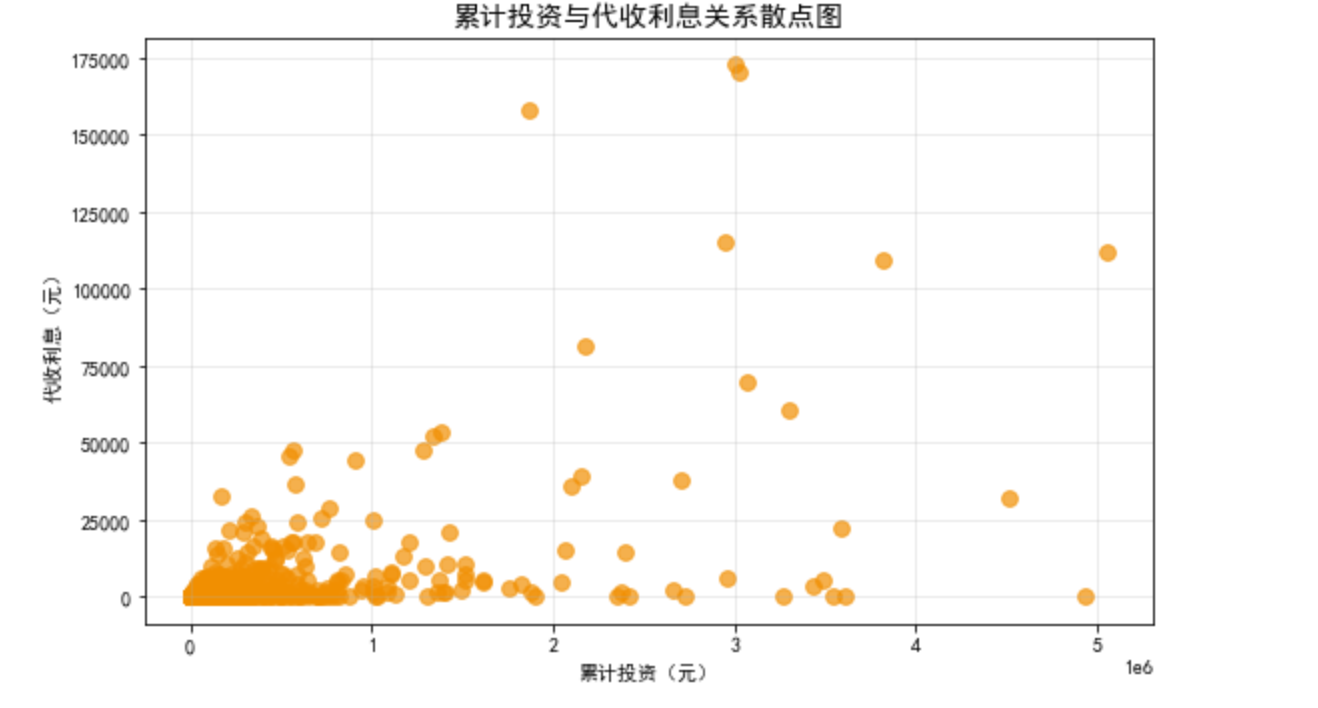
报告图 4 · 累计投资 vs 代收利息散点(弱-中等正相关,高净值区收益极度分散)
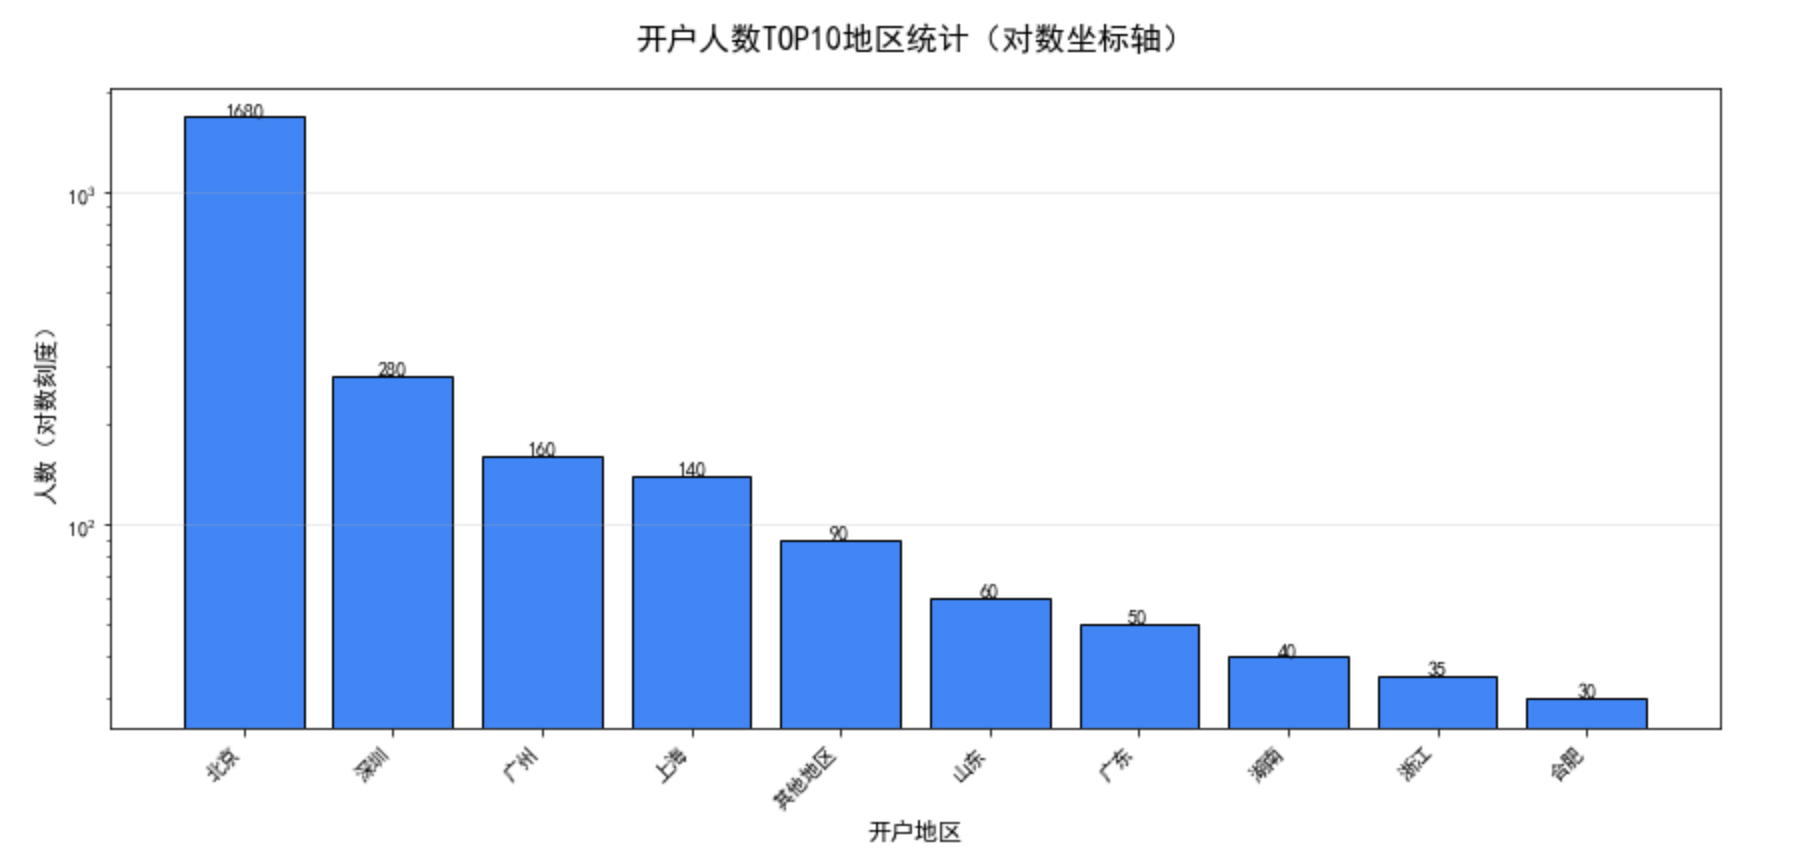
报告图 6 · 开户人数 TOP10 地区(北京断层领先,占 TOP10 近 60%)
④ 业务结论与落地建议
3 类
用户分层,金字塔结构
r=0.83
代收本金 × 代收利息
1,000 元
累计投资中位数(长尾)
近 60%
北京占 TOP10 开户数
- 分群画像:基础低活跃用户占 70%~80%(千元级小额、余额接近 0);大额稳健用户占 10%~15%(万元级、平台资金主力);高活跃高收益用户占 5%~10%(投标频次最高、单位收益最优)——呈典型金字塔结构
- 指标可用性:代收本金 × 代收利息 r=0.83、代收本金 × 累计投资 r=0.76、累计投资 × 代收利息 r=0.58,构成清晰的资金业务闭环;而已投标数与投资 / 收益呈中等相关(0.41~0.47);账户可用余额与其他指标 r<0.15,不具备价值区分度,不宜作为分群核心特征
- 落地建议:小额用户推低门槛短周期标的提升复投;高净值用户给专属大额标的与增值服务;针对回款偏慢做标的信息透明化与回款进度通知;用余额理财 / 加息券引导回款资金留存
- 渠道策略:北京为核心市场优先深耕并复盘成功经验,深圳 / 广州 / 上海作第二梯队投放,非一线地区评估下沉成本后择优合作
⑤ 项目难点与反思改进
- 难点 1|K 值不能只信一种指标:手肘法拐点有时不够锐利,必须与轮廓系数相互印证;本案两法一致指向 K=3,且 PCA 图上三簇界线清晰,才最终定案
- 难点 2|簇标签只是数字:0 / 1 / 2 无业务含义,需结合各簇指标均值 + PCA 位置 + 资金规律翻译成「基础低活跃 / 大额稳健 / 高活跃高收益」的业务命名
- 难点 3|指标量级差异掩盖结构:不标准化时距离被「累计投资」主导,聚类退化为按金额一刀切;标准化后才能让活跃度、收益类特征共同参与分群
- 改进方向:引入 RFM 类价值打分与 CLV 预测做交叉验证;对未回款用户单独建模(回款进度本身是重要的行为信号);将地区、渠道等类别特征纳入 K-Prototypes 以丰富分群维度
🎯 个人贡献
- 负责指标筛选与数据预处理:确定 5 项核心资金指标,完成清洗与 Z-score 标准化
- 负责聚类建模与选型:完成肘部法 + 轮廓系数联合定 K,搭建 K-Means 聚类与 PCA 降维可视化
- 负责业务解读:完成相关性分析与地区分布分析,把分群结果翻译为分层运营与渠道投放建议