首页 / 数据挖掘项目 / 垃圾短信识别
垃圾短信文本识别分类 项目 3 · 文本 NLP · 分类任务 · 小组作业
短信拦截的核心矛盾是「拦得准」与「误拦正常短信」之间取平衡。本案对 1 万余条标注短信做缺失与重复清理、正则文本清洗、jieba 分词与停用词过滤,再用 TF-IDF(5,000 维)向量化,训练 KNN、朴素贝叶斯、随机森林三模型横向对比——最终以「垃圾召回率 + 正常短信误拦数」双口径选出综合最优的拦截模型。
① 背景与业务目标
- 运营商 / 短信平台每日需拦截海量垃圾短信,靠人工规则库更新慢、漏网多
- 业务目标:用历史标注语料训练文本分类模型,自动识别垃圾短信,减少人工审核压力
- 真正的难点不是准确率,而是别把银行账单、验证码这类正常短信误拦(误拦代价远高于漏网)
② 数据集介绍
- 标注短信语料:短信文本 + 标签(0 正常 / 1 垃圾)
- 原始数据存在 text 列 53 条缺失;按短信内容去重发现 3,246 条重复短信
- 清洗后保留 7,649 条唯一短信,按 8:2 分层抽样 → 训练 6,119 条 / 测试 1,530 条
③ 技术栈
- Python 3 · Pandas / string 做数据与文本清洗
- jieba 中文分词 + 215 词停用词表过滤;TF-IDF(max_features=5000、sublinear_tf)向量化
- Scikit-learn:KNN、MultinomialNB、RandomForestClassifier;classification_report / 混淆矩阵评估;Matplotlib 可视化
④ 数据处理与特征工程
- 缺失值:text 为空即无分类价值,直接删除 53 条,不做无意义填充
- 重复值:以短信文本内容为准去重(同一短信群发多次会重复计入),3,246 条重复删除后留 7,649 条
- 文本清洗 clean_text():统一小写 → 正则移除 URL 链接 → 移除所有数字 → 剥离英文标点(string.punctuation)→ 合并多余空格
- 中文分词:jieba 精确模式 + seg_and_filter()——先剔中文标点,再过滤停用词、单字符与非中文词,输出空格分隔词序列 seg_text
- 特征工程(本案重点):TF-IDF 向量化,tokenizer=lambda x: x.split() 复用已分词结果避免二次切词,max_features=5000 控维度,sublinear_tf 平滑长文本词频
⑤ 建模方案与对比逻辑
- KNN:k=3、距离加权,余弦距离更适合高维稀疏的 TF-IDF 文本向量
- 朴素贝叶斯(MultinomialNB):文本分类经典基线,训练快、对词频特征天然适配,作速度与效果对照
- 随机森林(n_estimators=100):集成模型,特征随机采样抗过拟合,验证树模型在稀疏文本上的表现
- 对比逻辑:三模型统一在 1,530 条测试集上评估,除准确率外重点看「正常短信误拦数(假阳性)」与「垃圾漏网数(假阴性)」——误拦代价高,选型偏向保护正常短信
核心代码(Python · 点击放大看全文)
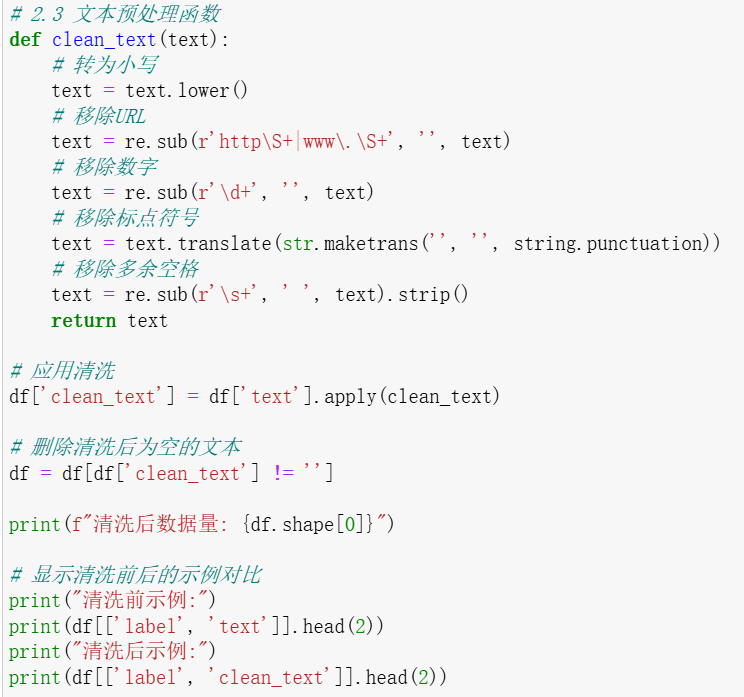
报告图 4-3 · 文本清洗:去 URL / 数字 / 标点,删除清洗后为空的文本
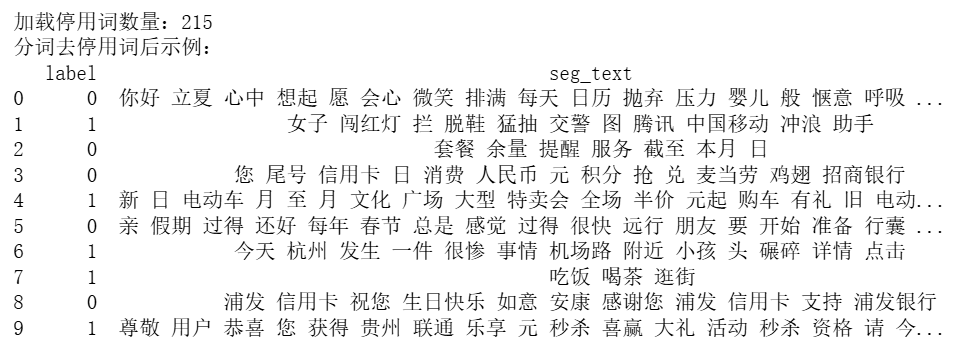
报告图 4-7 · jieba 分词 + 215 词停用词过滤,生成空格分隔的 seg_text
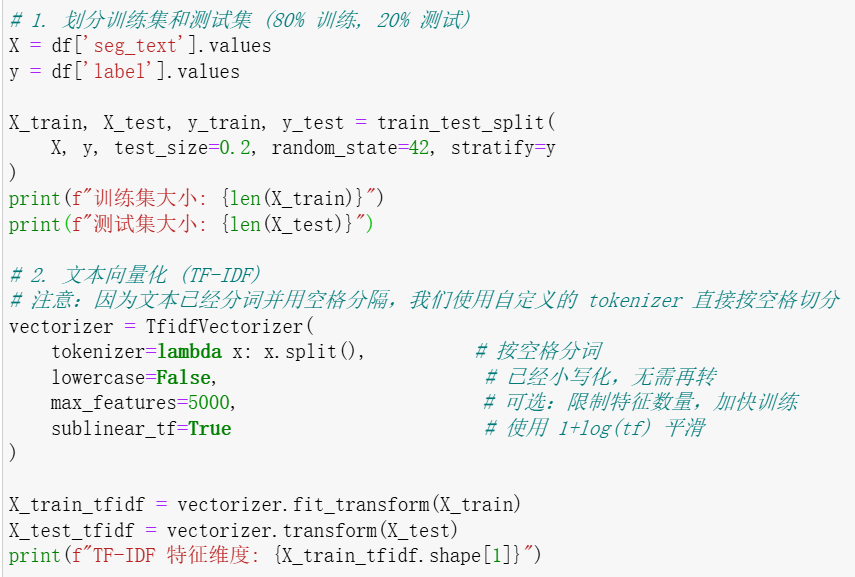
报告图 4-8 · 8:2 分层划分 + TF-IDF 向量化(max_features=5000)
模型评估与可视化(报告原图 · 点击放大)
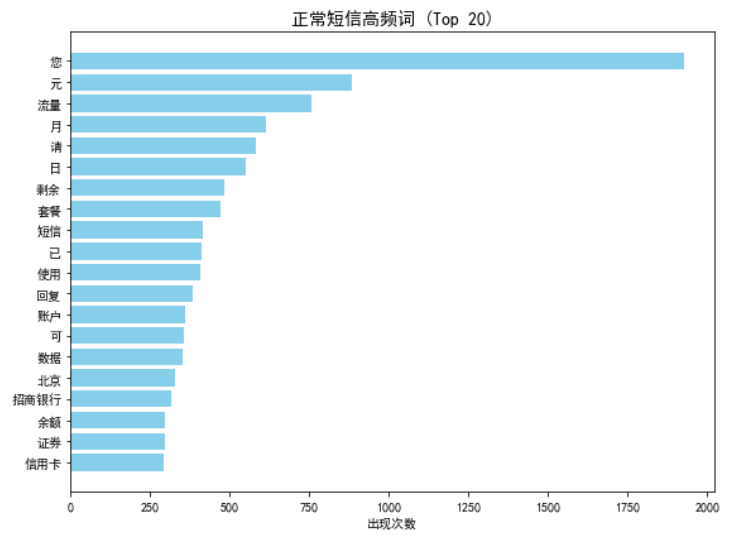
报告图 4-5 · 正常短信高频词:流量 / 套餐 / 余额 / 信用卡(服务提醒与金融通知)
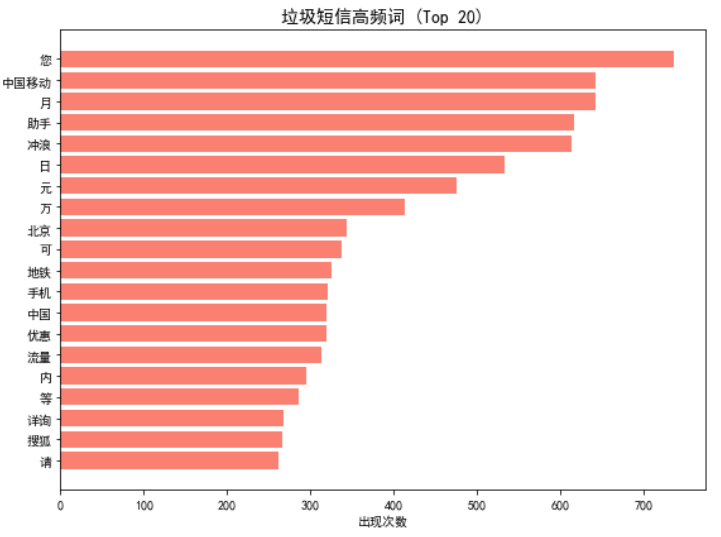
报告图 4-6 · 垃圾短信高频词:中国移动 / 助手 / 冲浪 / 优惠(伪装官方 + 诱导)
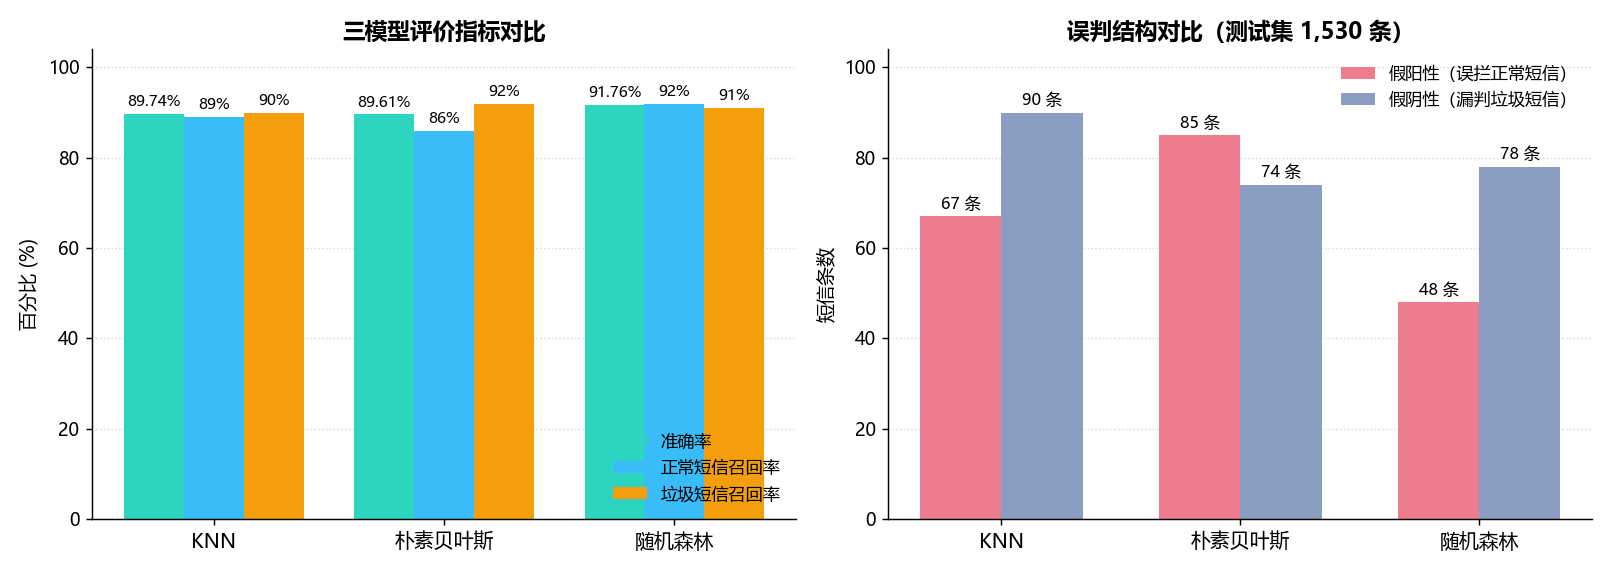
三模型对比 · 准确率 / 各类召回率 + 误判结构(依据报告表 1 绘制)
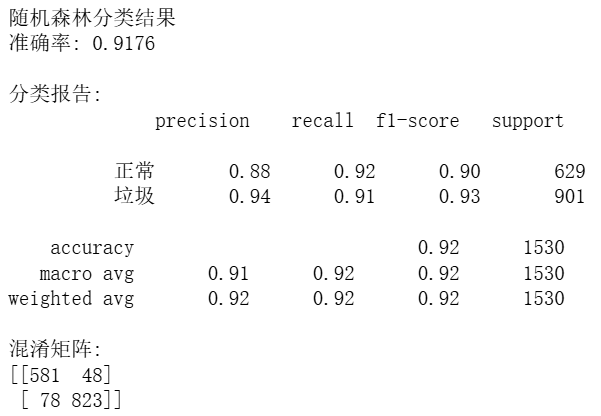
报告图 4-11 · 随机森林分类结果(准确率 91.76%,综合最优)
⑥ 业务结论与落地建议
91.76%
随机森林测试集准确率
48 条
最优模型误拦正常短信
5,000 维
TF-IDF 文本特征
3 种
分类算法横向对比
- 结论:随机森林综合最优(准确率 91.76%,垃圾召回 91%、垃圾精确率 94%),误拦正常短信仅 48 条,明显优于 KNN(67 条)与朴素贝叶斯(85 条)
- 定位差异:朴素贝叶斯垃圾召回率最高(92%、漏网仅 74 条)但误拦最多(85 条),适合「宁可多拦」的场景;KNN 两类召回均衡(89% / 90%)但整体精度居中
- 落地建议:默认用随机森林做拦截引擎,保护账单 / 验证码类正常短信;对政企等高漏网敏感场景切换朴素贝叶斯并叠加人工复核队列
- 可解释性:由正常 / 垃圾高频词差异沉淀「高危词表」——垃圾短信的「中国移动 / 助手 / 冲浪 / 详询 / 万」与正常短信的「流量 / 套餐 / 余额」形成清晰分野,可直接用于人工规则兜底
⑦ 项目难点与反思改进
- 难点 1|停用词表过大反噬效果:215 词表误收了有区分度的低频实词与行业词,导致有效特征被过滤、准确率下降;通过精简停用词(只留虚词 / 助词 / 标点)并保留中低频高分词,恢复关键语义特征
- 难点 2|同源语料的类别不均衡:混杂语料中高分类别占比过大会让模型「全预测多数类」、少数类 F1 趋近于 0;对策是 SMOTE 过采样 + 随机欠采样 + 类别权重,并把评估目标从整体准确率改为 F1 / 宏平均
- 改进方向:超参数调优(增加树数量、限制最大深度)与卡方检验特征选择,尝试把准确率突破 93%;引入词向量 / 预训练模型替代纯词频特征,补足语义泛化能力
🎯 个人贡献
- 负责短信语料的数据清洗:缺失值与重复短信处理、clean_text 文本清洗函数的编写与验证
- 负责中文分词与 TF-IDF 特征工程环节:停用词过滤、jieba 分词、向量化参数设置与训练 / 测试集划分
- 负责三种算法的训练评估与对比论证:完成混淆矩阵与多指标可视化,输出「误拦代价优先」的模型选型结论