首页 / 数据挖掘项目 / 汽车销量预测
2023 年汽车销量预测分析 项目 2 · 回归任务 · 多模型对比
销量预测直接决定排产与渠道投放。本案以 2023 年 4,902 条分车型销量样本为基础,先做售价清洗与特征共线性诊断(VIF < 5),再在同一份分层切分数据上对比多元线性回归与随机森林回归:R² 从 0.903 提升到 0.993,并验证了自定义新车型的销量预估能力。
① 背景与业务目标
- 汽车行业排产、定价与渠道投放都依赖销量预判,靠经验判断误差大
- 业务目标:量化「车型 / 厂商 / 月份 / 排名 / 售价」对销量的影响,产出可复用的预测模型
- 核心问题:哪些特征真正驱动销量?线性模型够不够用,非线性模型能提升多少?
② 数据集介绍
- 来源:和鲸社区公开数据集《中国汽车分车型每月销售量(2015—2023)》
- 清洗后样本:4,902 条(仅保留 2023 年记录,剔除售价为 0 的无效行)
- 字段:年份 / 月份 / 排名 / 车型 / 厂商 / 售价(万元)/ 销量(连续型目标变量)
③ 技术栈
- Python · Pandas / NumPy 数据清洗与特征衍生
- Scikit-learn:LinearRegression、RandomForestRegressor、Pipeline、ColumnTransformer、OneHotEncoder、StandardScaler
- Statsmodels 做 VIF 共线性检验;Matplotlib 绘图;Excel 完成年份筛选与异常行剔除
④ 数据处理与特征工程
- 数据筛选:Excel 先按「年份=2023」筛选,再剔除售价 0.00—0.00 的无效记录,得 4,902 条干净样本
- 特征衍生:从售价区间文本中提取「最低售价」数值特征,并新增售价区间维度
- 缺失与偏态:dropna 清理缺失记录;销量呈严重右偏,用对数变换缓解极端值影响,箱线图标记离群点
- 共线性诊断:相关系数热力图 + VIF 检验(月份 2.97 / 排名 2.93 / 最低售价 2.69,均远低于 5)→ 判定无多重共线性,无需 PCA 降维
- 编码与标准化:厂商 / 车型等分类特征做独热编码,数值特征标准化,全部封装进 ColumnTransformer + Pipeline,避免数据泄露
- 抽样策略:按售价区间分层划分训练集 / 测试集,避免高价车型分布不均导致评估失真
⑤ 建模方案与对比逻辑
- 多元线性回归:可解释性优先的基线模型,验证销量与各特征的线性关系强度
- 随机森林回归(100 棵树):捕捉非线性关系与特征交互,处理离群值更稳健
- 对比逻辑:同一份分层切分数据 + 同一评估口径(R² / MSE)+ 同一张「真实值 vs 预测值」散点图,排除评估差异带来的假提升
- 落地验证:把自定义新车型样本转成同一标准化格式,实测模型的业务可用性
核心代码(Python · 点击放大看全文)
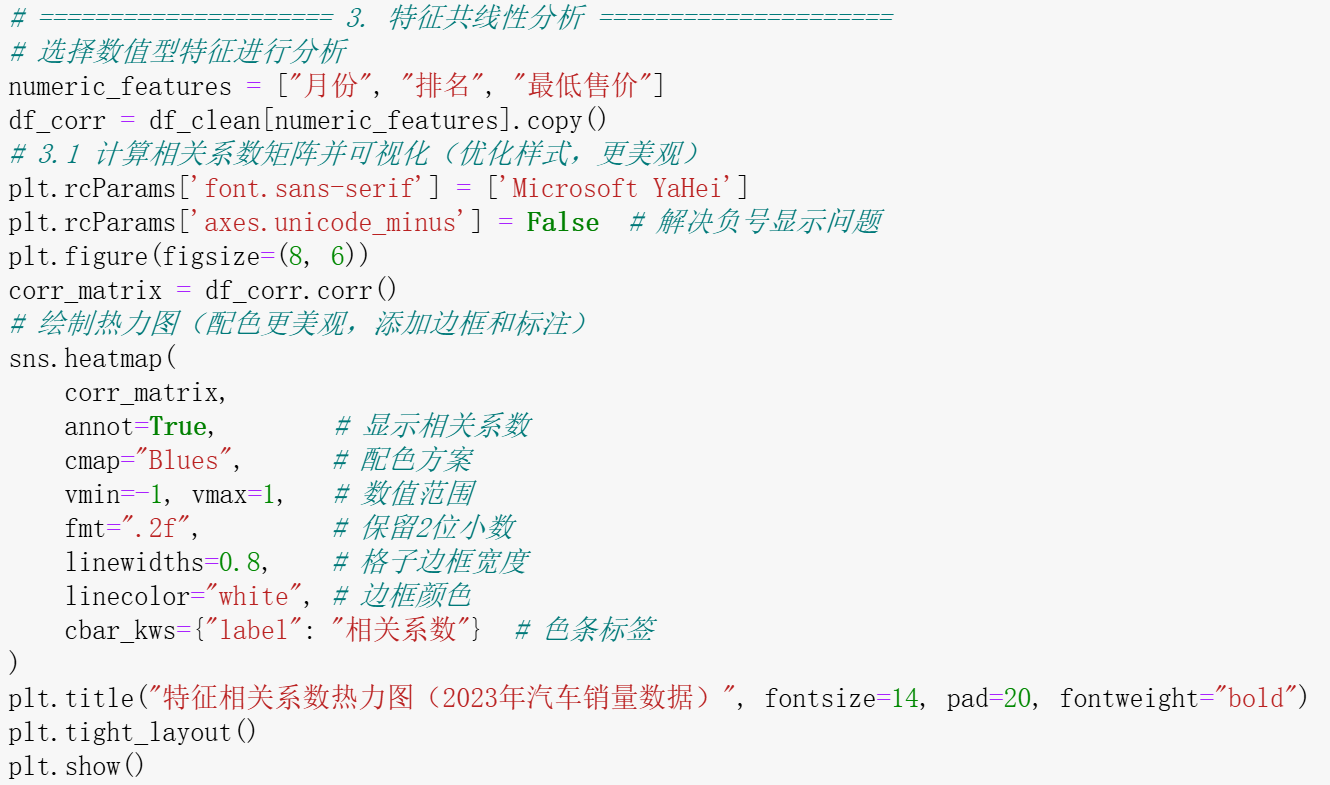
报告图 1-4 · 特征共线性分析:相关系数矩阵 + statsmodels 计算 VIF 值
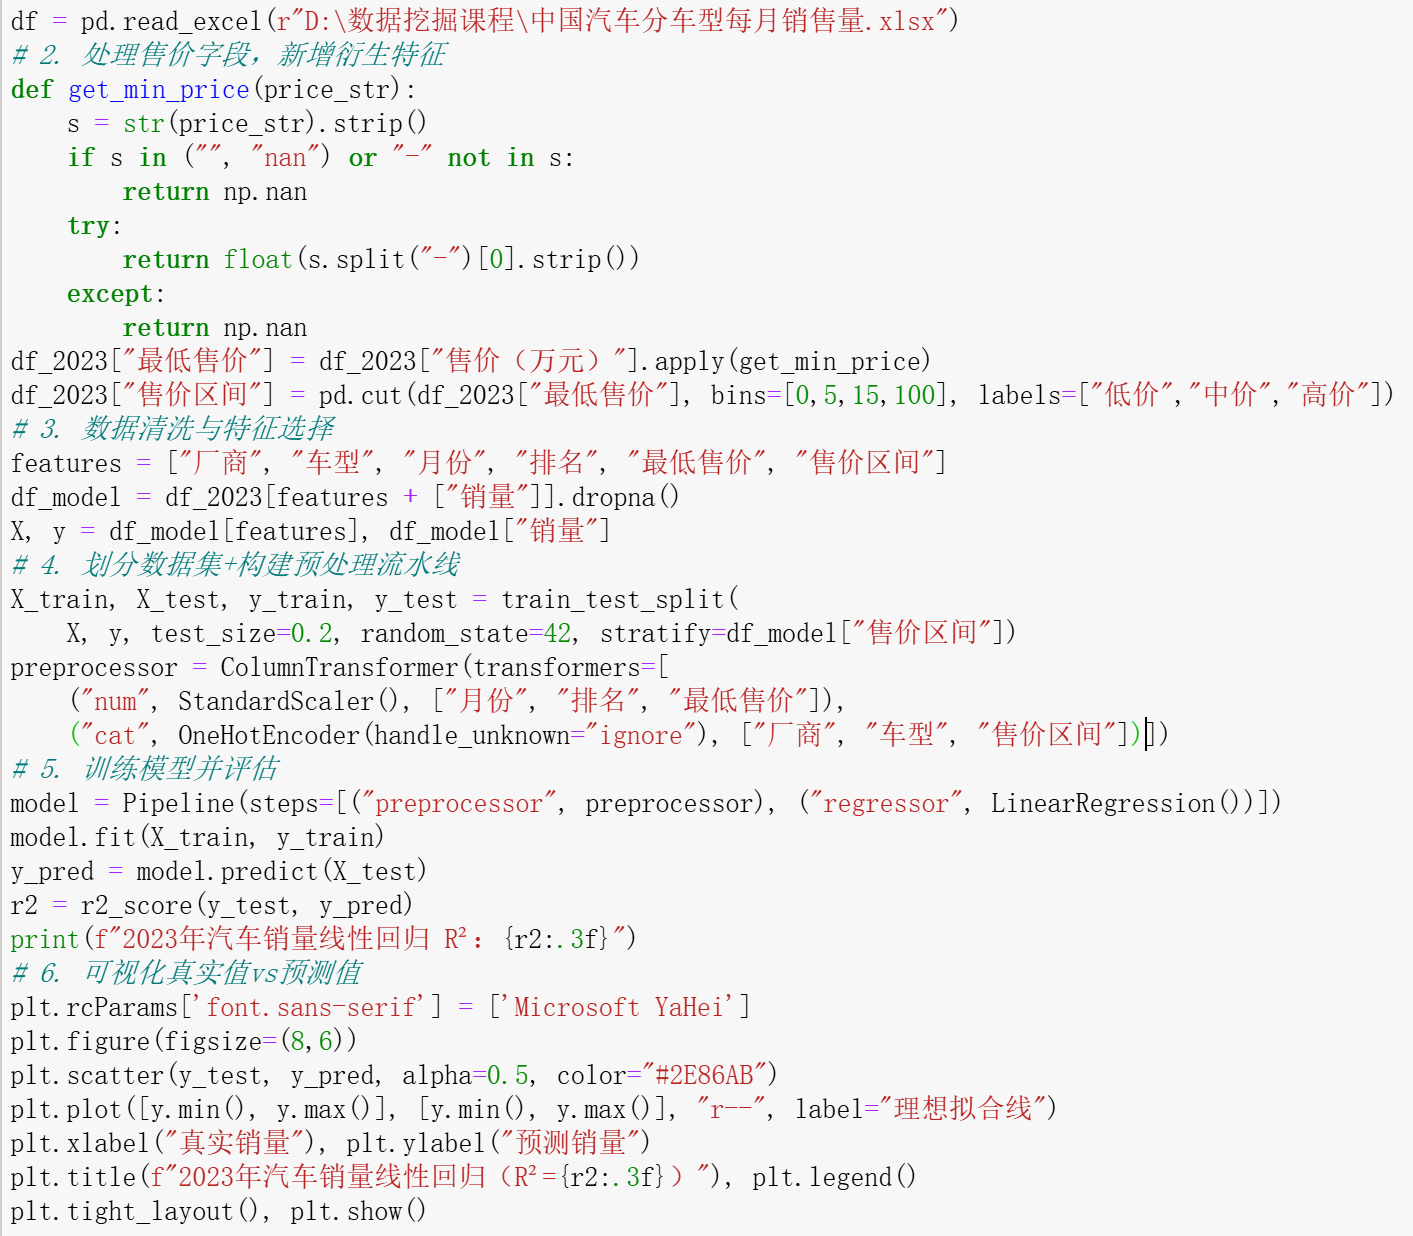
报告图 1-8 · 多元线性回归:ColumnTransformer + Pipeline 封装训练与评估
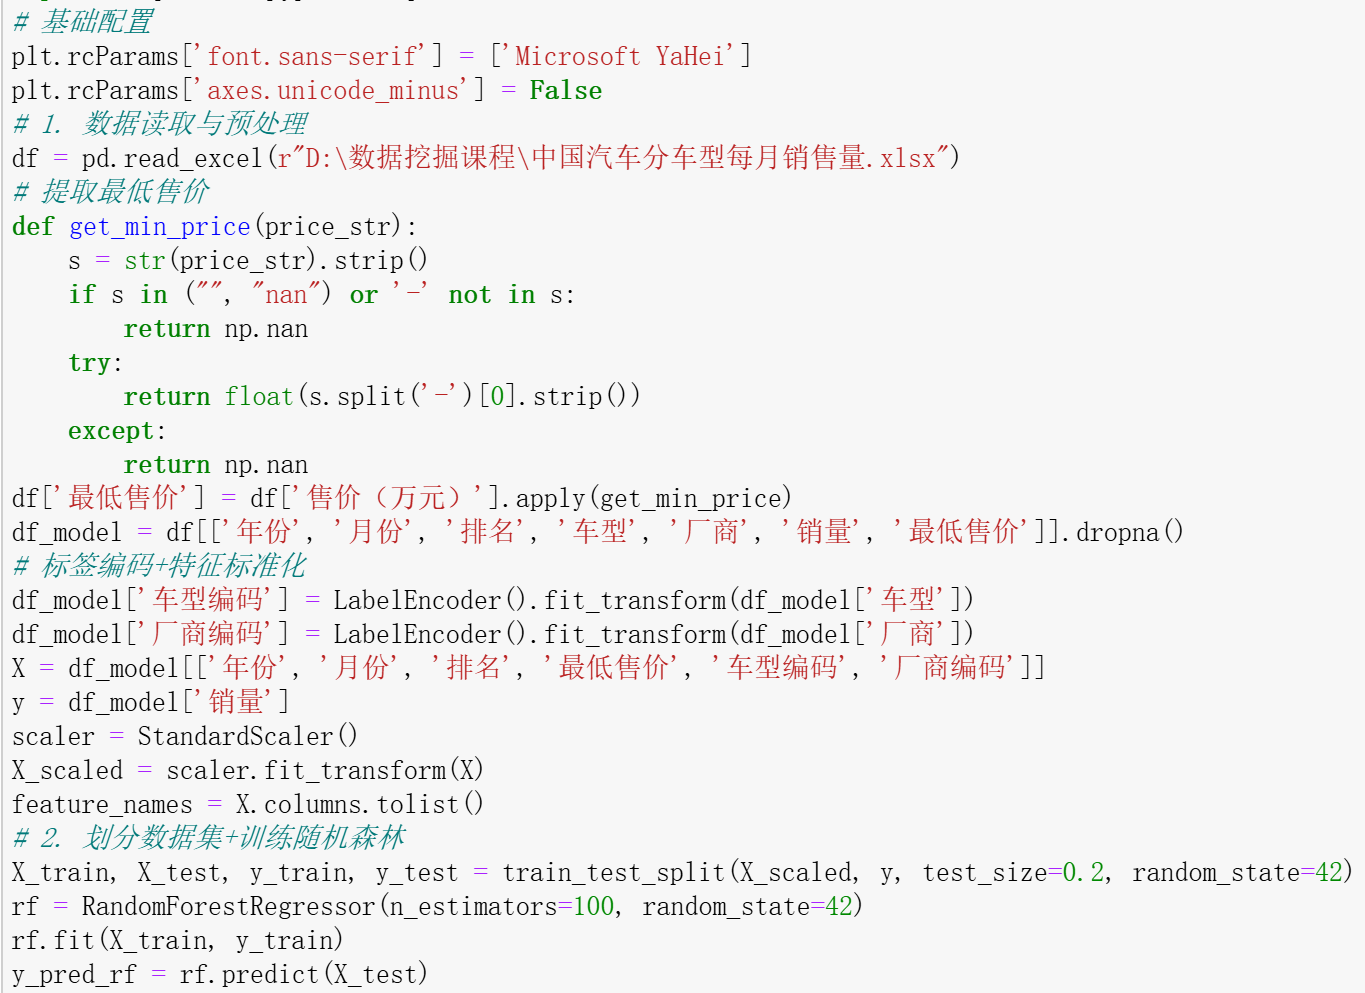
报告图 1-10 · 随机森林回归:标签编码、100 棵树训练与 MSE / R² 评估
模型评估与可视化(报告原图 · 点击放大)
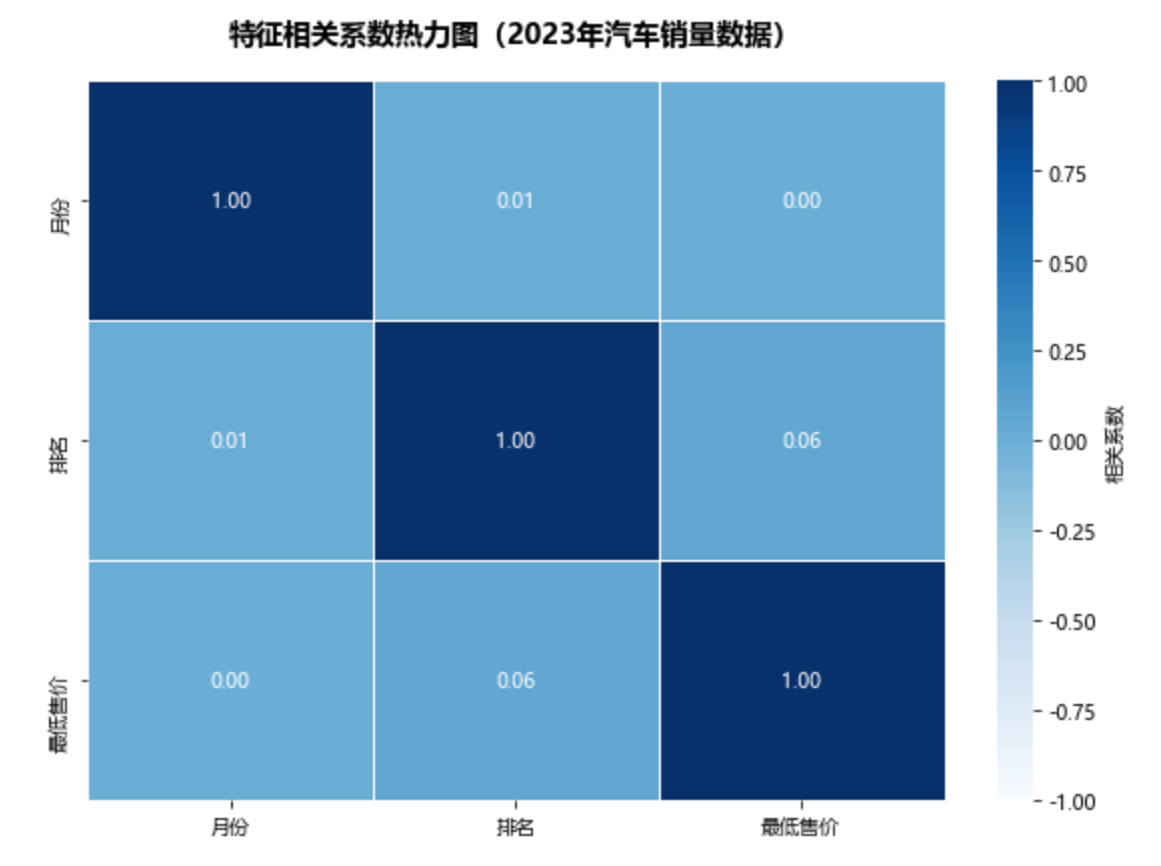
报告图 1-6 · 特征相关性热力图(各特征相关系数均 < 0.1)
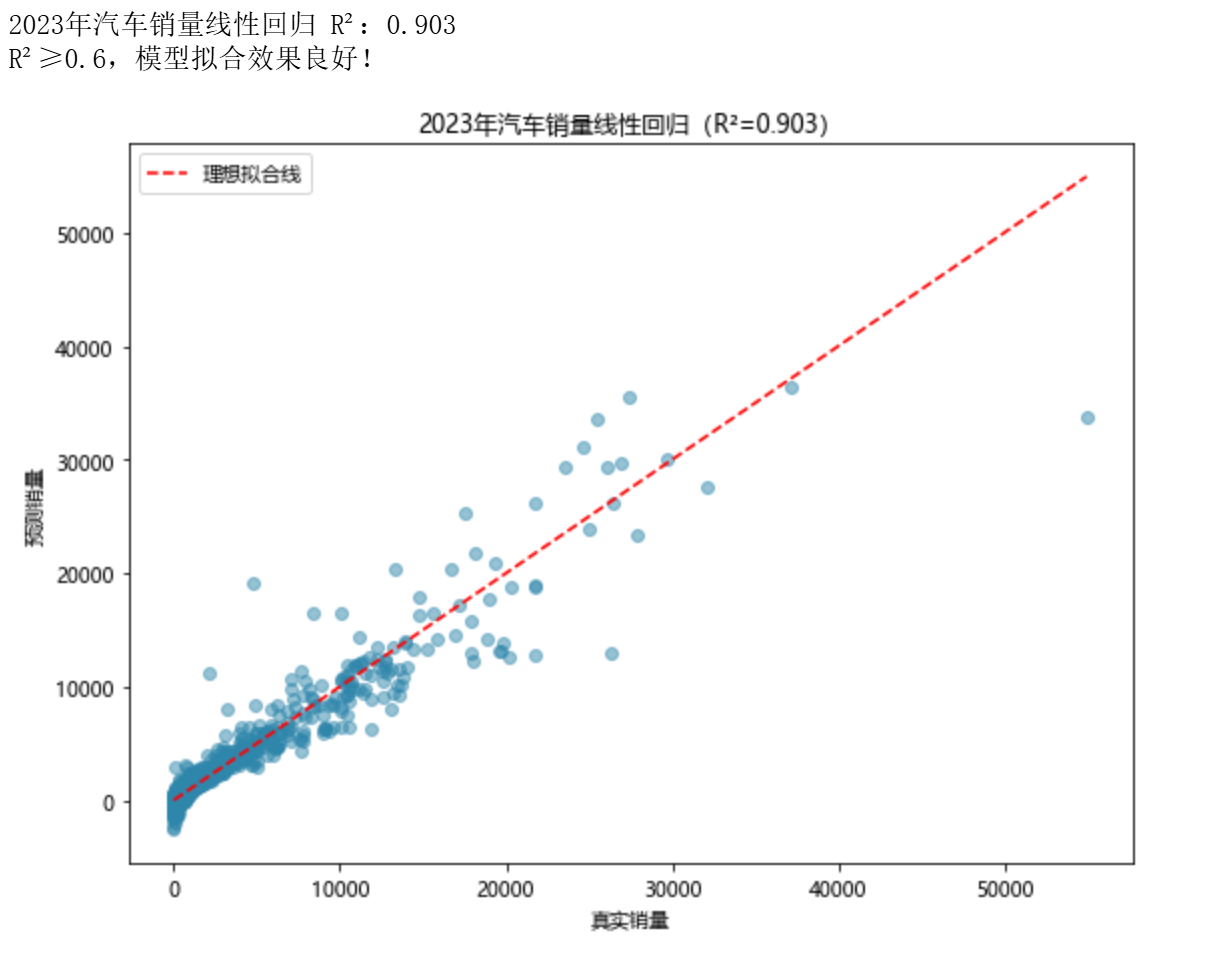
报告图 1-9 · 多元线性回归 真实值 vs 预测值(R² = 0.903)
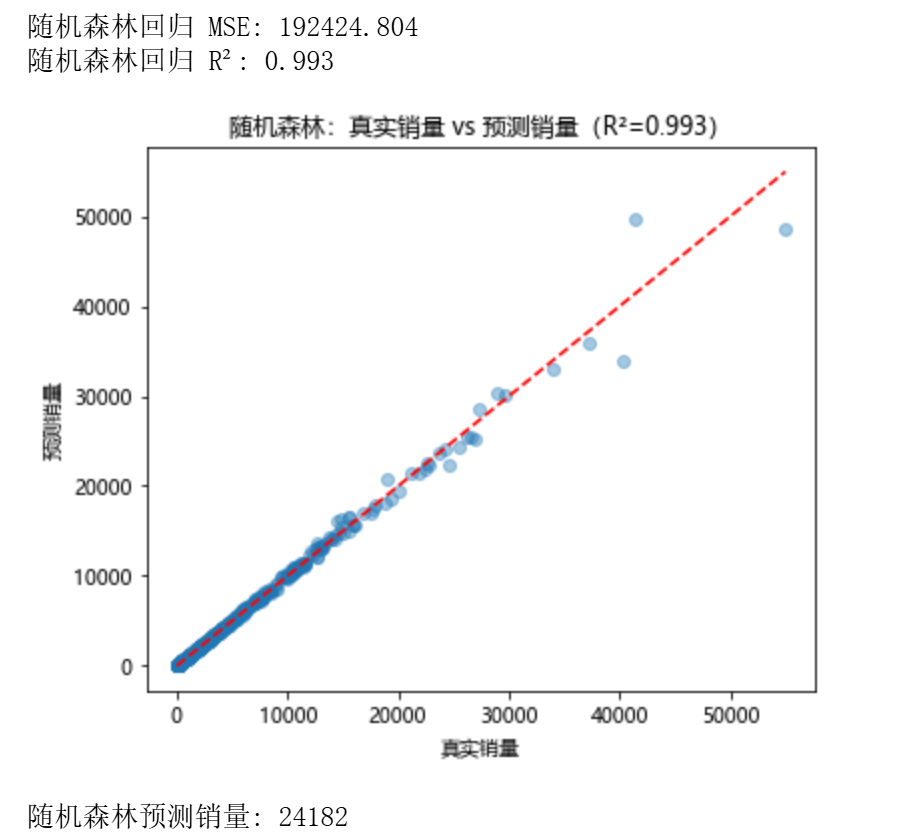
报告图 1-12 · 随机森林回归 真实值 vs 预测值(R² = 0.993)
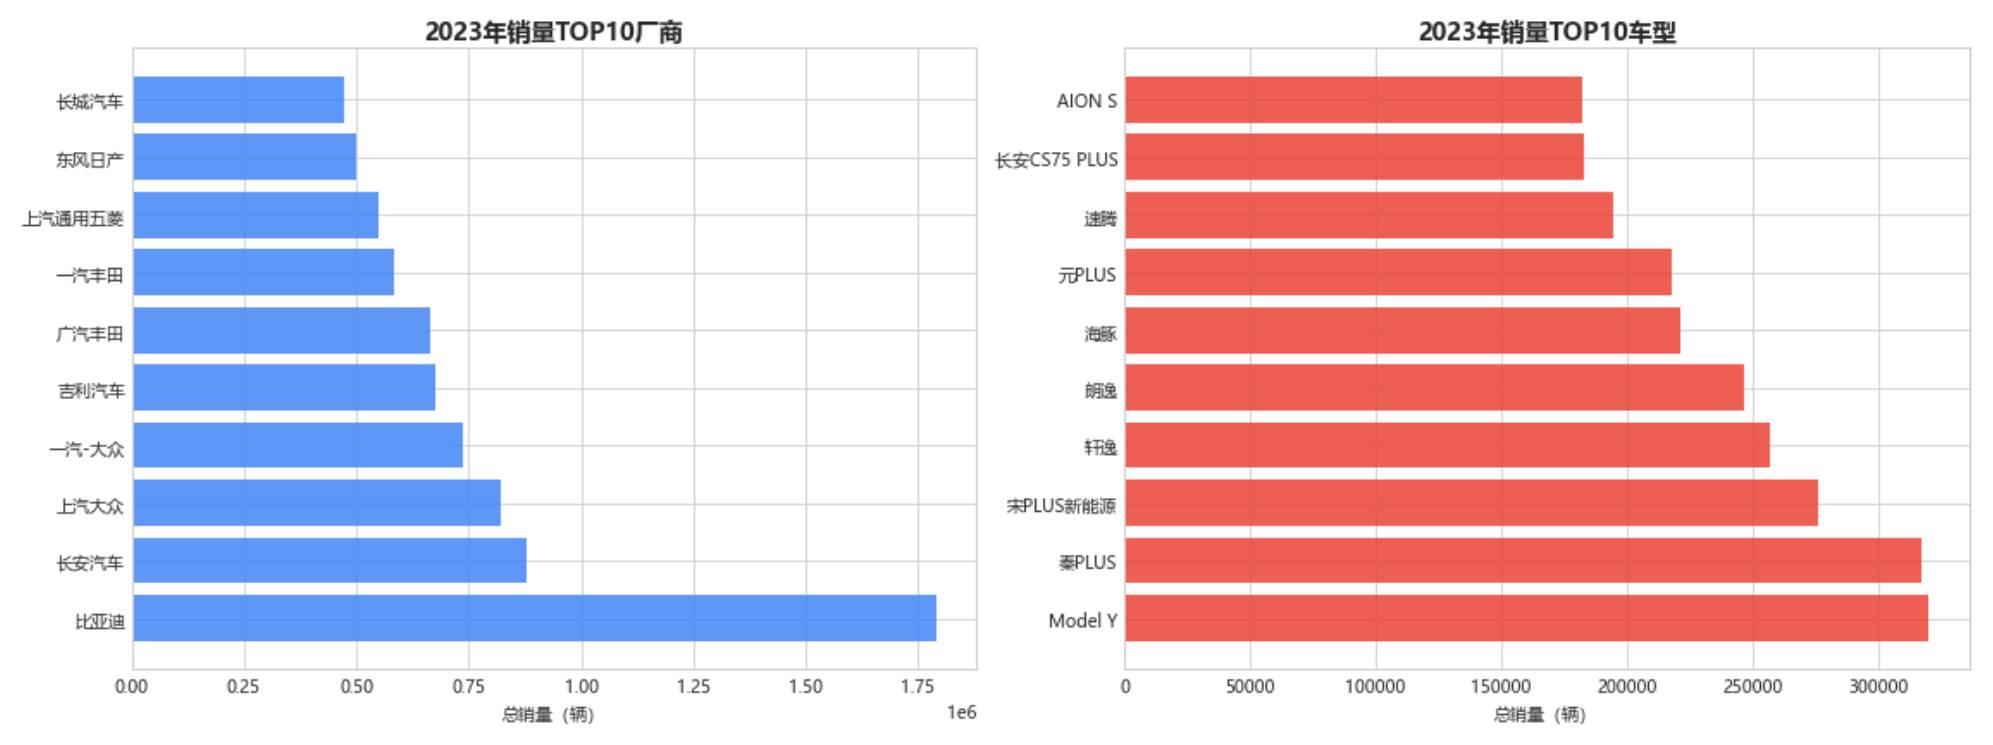
报告图 1-14 · 销量 TOP10 厂商与 TOP10 车型(市场结构洞察)
⑥ 业务结论与落地建议
4,902
条清洗后的建模样本
0.903
线性回归 R²
0.993
随机森林 R²
2 种
回归模型同口径对比
- 模型选型:随机森林 R²=0.993、MSE=192,424.8,散点高度贴合理想线,显著优于线性回归的 0.903;主流车型拟合极好,仅个别爆款存在轻微偏差
- 特征结论:VIF 与热力图共同证明月份 / 排名 / 售价之间无共线性,可直接入模,无需降维——省掉了不必要的 PCA 环节
- 市场洞察:厂商维度比亚迪断层领先,呈「一超多强」格局;车型维度新能源车(Model Y、秦 PLUS)位居前列,家用紧凑型车仍是主流,销量呈长尾分布
- 落地建议:以随机森林输出排产与库存参考值;爆款车型补充上市时间、促销力度等特征做二次校正;对外汇报用线性模型讲清因子方向,对内决策用随机森林保精度
- 可用性验证:自定义新车型样本实测预估销量 24,182 辆,模型具备业务落地能力
⑦ 项目难点与反思改进
- 难点 1|找不到合适的数据集:明确「连续型目标 + 强相关特征 + 时间维度」三条筛选标准后,才在和鲸社区定位到该汽车销量数据集
- 难点 2|售价格式不统一、销量严重右偏:自定义函数提取最低售价并统一格式,dropna 去无效记录,对数变换压缩极端值,箱线图识别离群点
- 难点 3|图表中文乱码、坐标轴标签重叠:统一全局字体与配色,TOP10 榜单改用水平柱状布局避免标签挤压
- 改进方向:引入车型级别、地区销量等维度;尝试 GBDT / LightGBM 替代单一随机森林;对高销量离群点做业务溯源而非直接剔除
🎯 个人贡献
- 独立完成数据集选型与论证、Excel 预处理与 Python 数据清洗
- 独立编写全部建模代码:共线性诊断、双模型 Pipeline 训练、指标评估与自定义样本预测
- 完成实验报告与结论分析,对比双模型优劣并明确各自适用场景